Derechos de autor y contenido generado por IA: qué riesgos legales asume tu empresa
Publicado el 7 de septiembre de 2026
🧮 Herramienta gratuita · sin registro
Base legal aplicable a este tipo de contenido:
Esta herramienta ofrece una orientación general a partir del art. 5 TRLPI, el art. 7.6 LO 1/1982 y el art. 50 del AI Act. No sustituye una valoración legal específica de tu caso, sobre todo si el contenido combina varios de estos factores a la vez.
Imagina que el equipo de marketing de tu empresa genera con IA la imagen de portada de una campaña, un texto para la web y hasta la voz de un locutor para un anuncio en redes. Todo sale en una tarde, sin coste de producción, y nadie se plantea una pregunta que debería hacerse antes de pulsar “publicar”: ¿de quién son, legalmente, esos contenidos? La respuesta incomoda a bastantes empresas que ya llevan meses trabajando así, porque en varios de esos casos la respuesta es “de nadie” — y en otros, el problema no es que no sean tuyos, sino que podrían ser de otra persona.
Lo que dice la ley española (y que casi nadie lee antes de publicar)
El artículo 5 del Texto Refundido de la Ley de Propiedad Intelectual (TRLPI) es tajante: se considera autor a la persona natural que crea una obra. No a una empresa, no a un software, no a un modelo de lenguaje. La consecuencia práctica es incómoda para cualquier negocio que publique contenido generado por IA sin apenas intervención: ese contenido, tal cual sale de la máquina, no tiene un titular de derechos de autor que pueda ejercerlos. Nadie puede demandar a un competidor por copiarlo, porque nadie es su dueño en sentido legal.
Esto no es una rareza española. El derecho de la Unión Europea limita la protección por derechos de autor a las obras que sean fruto del intelecto humano, en las que se reconozca la huella personal de quien las crea a través de decisiones libres y creativas. Estados Unidos ha llegado a la misma conclusión por otra vía: la Oficina de Copyright estadounidense lleva rechazando desde 2023 el registro de obras generadas íntegramente por IA, precisamente por falta de autoría humana.
Cuánta intervención humana hace falta para que el contenido sí sea tuyo
Aquí no hay un porcentaje oficial ni una tabla que puedas consultar. Lo que exige la doctrina es que se reconozca una decisión creativa propia: reescribir un texto de forma sustancial, seleccionar entre varias versiones generadas y combinarlas con un criterio propio, o partir de la IA solo como borrador para construir algo distinto encima. Usar el resultado tal cual, sin tocarlo, es el escenario de menor protección. Por eso conviene adoptar una costumbre sencilla: guarda los prompts, las versiones intermedias y una breve nota de qué cambiaste y por qué. No es un trámite legal formal, pero si algún día necesitas acreditar tu aportación creativa —ante un tribunal o simplemente ante un cliente que cuestiona la autoría— esa documentación es la diferencia entre poder demostrar algo y no poder demostrar nada.
El riesgo menos comentado: que tu contenido infrinja derechos de otro
Hay una preocupación que se lleva casi todo el foco —si lo que genero es mío— y otra que se comenta mucho menos: que lo que genere la IA se parezca demasiado a algo que ya existe y que sí está protegido. Los modelos de imagen y de texto se entrenan con volúmenes enormes de contenido protegido, y en ocasiones el resultado reproduce elementos reconocibles: el estilo inconfundible de un ilustrador, la composición de una fotografía de stock, o directamente una marca registrada.
El caso más citado en 2025 fue el de Getty Images contra Stability AI en el Reino Unido. El tribunal desestimó la reclamación principal de infracción de derechos de autor —consideró que el entrenamiento del modelo se había hecho fuera de la jurisdicción británica—, pero sí dio parcialmente la razón a Getty en un punto distinto: varias imágenes generadas por Stable Diffusion reproducían de forma reconocible la marca de agua de Getty Images, lo que el tribunal calificó de infracción marcaria. La jueza autorizó además a Getty a apelar la parte del fallo que le fue desfavorable. La lección para una empresa española no es sobre derechos de autor exactamente, sino sobre marcas: si el contenido que generas reproduce un logo, una marca de agua o un elemento distintivo de otro, la Ley de Marcas puede aplicar aunque la Ley de Propiedad Intelectual no lo haga.
Getty contra Stability AI no es un caso aislado. En Estados Unidos hay abiertas decenas de demandas similares contra los grandes desarrolladores de IA — The New York Times contra OpenAI y Microsoft, o un grupo de editoriales musicales contra Anthropic por el uso de letras de canciones protegidas, entre otras — y ninguna ha llegado todavía a una sentencia firme que fije un criterio definitivo. Para una empresa que simplemente usa estas herramientas, sin ser quien las entrena, el riesgo directo es menor que para OpenAI o Anthropic, pero conviene entender el contexto: es un terreno legal que se está escribiendo en tiempo real, y lo que hoy parece una zona gris tranquila puede quedar resuelto en una u otra dirección según sentencias que todavía están por dictarse.
Por qué esto va a más: el marketing ya es el mayor usuario de IA generativa
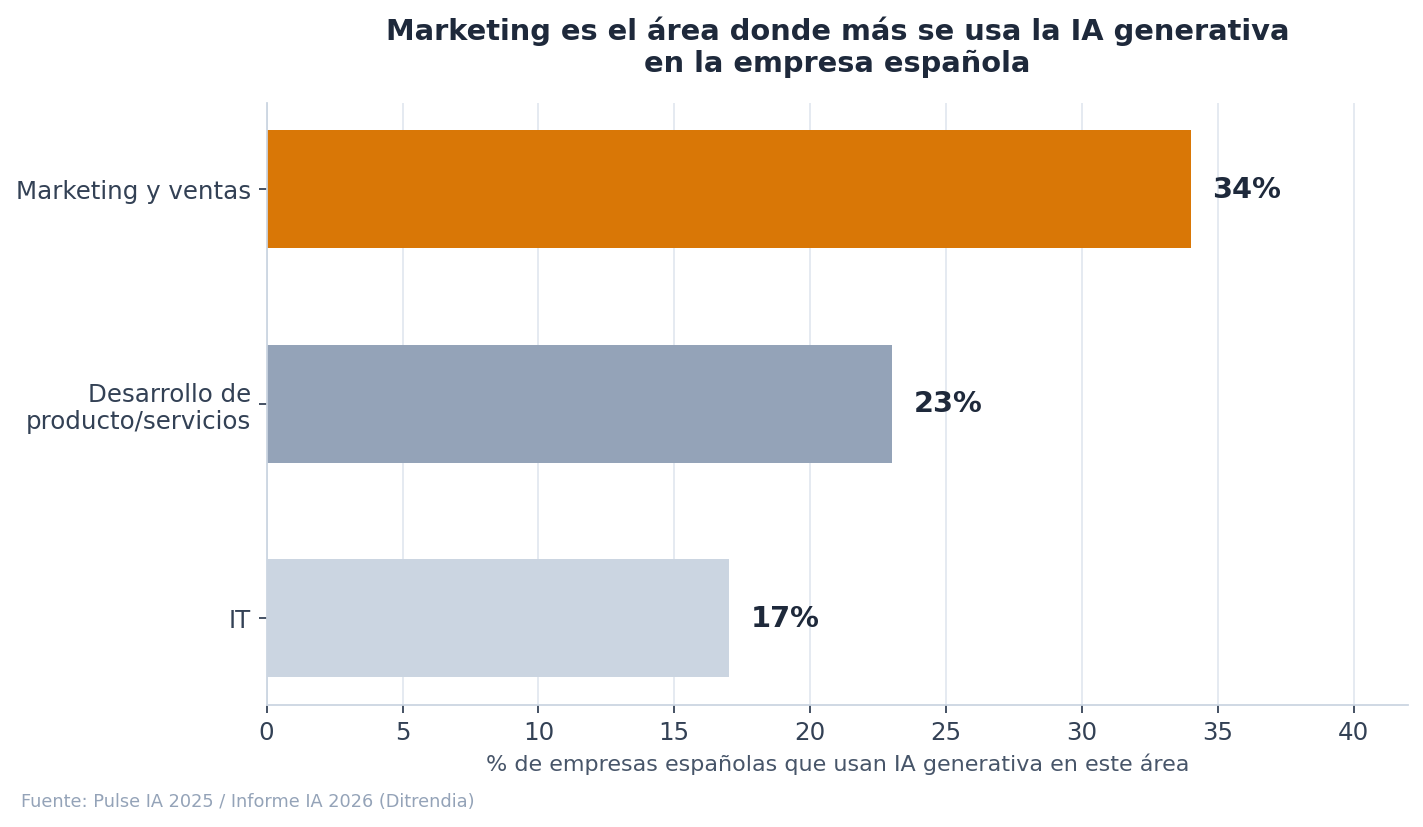
Según el informe Pulse IA 2025, marketing y ventas es el área de la empresa española donde más se usa la IA generativa, con un 34% de adopción, por delante de desarrollo de producto (23%) e IT (17%). El Informe IA 2026 de Ditrendia va más allá: calcula que en 2026 el 80% de los equipos de marketing integrarán la IA en su trabajo diario. Dicho de otro modo, el área que más contenido publica de cara al público —textos, imágenes, vídeo, campañas— es también la que más rápido está adoptando una tecnología cuyas reglas de propiedad y de riesgo todavía se están escribiendo sobre la marcha, sentencia a sentencia.
Si entrenas tu propia IA con contenido ajeno: minería de datos y opt-out
El riesgo cambia de naturaleza si tu empresa no se limita a usar ChatGPT o Midjourney, sino que entrena o afina su propio modelo con datos recopilados de internet —por ejemplo, para un chatbot especializado en tu sector, entrenado con artículos, catálogos o documentación de terceros—. El Real Decreto-ley 24/2021 incorporó al derecho español la excepción de minería de textos y datos: con carácter general, se permite usar contenido protegido para entrenar sistemas de IA, incluso con fines comerciales, salvo que el titular se haya opuesto expresamente.
Esa oposición —el opt-out del artículo 67.3— tiene que expresarse de forma legible por máquina: normalmente mediante metadatos en el propio contenido o instrucciones específicas en el archivo robots.txt de una web. Si tu empresa recopila datos de terceros para entrenar algo propio, comprobar esas señales antes de usar el contenido no es opcional: es la diferencia entre operar dentro de la excepción legal o fuera de ella. Este matiz suele pasar desapercibido porque la mayoría de empresas solo consumen modelos ya entrenados por otros, no entrenan los suyos — pero el número de pymes que sí lo hace, con proveedores especializados, crece cada trimestre.
Cuando el contenido generado usa la cara o la voz de una persona real
Otro terreno donde el riesgo se ha disparado en 2026 es el de los deepfakes con fines comerciales: usar IA para clonar la voz de un locutor, generar el rostro de un “empleado” ficticio para una campaña, o crear un testimonio de cliente que en realidad no existe. El artículo 7.6 de la Ley Orgánica 1/1982 ya calificaba como intromisión ilegítima usar el nombre, la voz o la imagen de una persona con fines publicitarios sin su consentimiento, y esa protección se aplica igual si la voz o la imagen se han generado o clonado con IA en lugar de grabarse directamente.
La norma se está reforzando todavía más: el Consejo de Ministros aprobó el 7 de julio de 2026 un proyecto de ley que moderniza la protección del derecho al honor, la intimidad y la propia imagen específicamente frente a deepfakes y al uso comercial no autorizado de la voz. En paralelo, la AEPD ha empezado a tratar la generación de imágenes sintéticas que permiten identificar a una persona real como un tratamiento de datos personales sujeto al RGPD, lo que abre una segunda vía sancionadora —la de protección de datos— además de la civil. Para una empresa, la conclusión práctica es simple: si el contenido generado representa o imita a una persona real, identificada o identificable, necesitas su consentimiento explícito antes de usarlo, sea empleado, cliente o cualquier tercero.
Lo que exige el AI Act sobre el contenido sintético, ya en vigor
El Reglamento (UE) 2024/1689 —el AI Act, que ya tratamos en detalle en el comprobador de riesgo del AI Act— añade una capa más, centrada no en la propiedad del contenido sino en su transparencia. Desde el 2 de agosto de 2026 es exigible el artículo 50: cualquier contenido sintético —imagen, audio o vídeo generado o alterado sustancialmente por IA que pueda confundirse con contenido auténtico— debe quedar identificado como tal, de forma clara y, cuando sea técnicamente posible, mediante metadatos legibles por máquina. La obligación recae tanto en quien desarrolla el sistema como en quien lo despliega en su empresa, con excepciones limitadas para usos manifiestamente artísticos, satíricos o creativos siempre que quede claro el contexto.
Hacia dónde va la norma: lo que piden SGAE y CEDRO
Las entidades de gestión de derechos —SGAE, CEDRO y el resto agrupadas en ADEPI— llevan meses presionando por una regulación que exija trazabilidad y compensación económica cuando la IA generativa se entrena o se nutre de su repertorio. No es una postura contraria a la tecnología en sí, sino a su uso sin consentimiento, sin transparencia y sin pago. El Gobierno, autores, editores y CEDRO llegaron en octubre de 2025 a un compromiso para impulsar una IA “española” respetuosa con los derechos de autor, aunque el decreto que debía concretarlo se paralizó a comienzos de ese mismo año ante el rechazo del sector cultural a algunos de sus términos. La dirección es clara aunque el calendario no lo sea: es razonable esperar que en los próximos años aparezcan mecanismos de licencia colectiva o de compensación que hoy no existen, y que una empresa que hoy opera en una zona gris pueda encontrarse mañana con una obligación de pago retroactiva o un régimen de licencias que hoy todavía no existe.
Cómo protegerte antes de publicar
No hace falta parar de usar IA generativa —sería absurdo, dado lo que ya invierte en ella el propio sector del marketing— pero sí conviene incorporar una rutina mínima antes de que cualquier contenido salga a producción:
- Documenta el proceso: herramienta usada, prompt, y qué edición humana se aplicó después.
- Si el contenido representa a una persona real —empleado, cliente, actor de stock generado con IA que se parece a alguien identificable—, consigue su consentimiento explícito por escrito.
- Revisa si el resultado reproduce marcas, logos o estilos muy reconocibles de terceros antes de usarlo en un contexto comercial.
- Si entrenas modelos propios con datos externos, comprueba las señales de opt-out del contenido de origen.
- Etiqueta como sintético el contenido que lo requiera según el artículo 50 del AI Act.
- Ante cualquier campaña de cierto volumen o presupuesto, una revisión legal puntual —no una auditoría completa— suele costar mucho menos que gestionar una reclamación una vez publicada la campaña.
Ese último punto no es un añadido retórico: el coste de una consulta puntual a un despacho especializado en propiedad intelectual y IA ronda habitualmente entre 150 y 400 euros para revisar una campaña o una política interna de uso, una cifra que compensa de sobra frente al coste de retirar una campaña ya publicada, renegociar con un cliente que reclama su imagen, o defenderse ante una demanda por infracción marcaria como la que enfrentó Stability AI.
Fuentes
- Real Decreto Legislativo 1/1996, Texto Refundido de la Ley de Propiedad Intelectual, art. 5, BOE
- Real Decreto-ley 24/2021, excepción de minería de textos y datos (arts. 65-80), BOE
- Ley Orgánica 1/1982, de protección del derecho al honor, la intimidad y la propia imagen, art. 7.6, BOE
- Tribunal británico acoge parcialmente la demanda de Getty Images contra Stability AI
- Pulse IA 2025: la Inteligencia Artificial en las empresas españolas, IPMark
- Informe IA 2026: Inteligencia Artificial en España y el mundo, Ditrendia
- El Gobierno, autores, editores y CEDRO se comprometen a impulsar una IA española respetuosa con los derechos de autor, ADEPI
- Reglamento (UE) 2024/1689 (AI Act), artículo 50, EUR-Lex
Escrito por José G. · Informático
Informático con más de 30 años de experiencia profesional, 20 de ellos gestionando documentación confidencial —tanto administrativa como sanitaria— en el entorno empresarial. NoLoDigoYo nace de esa experiencia práctica con datos sensibles: cada herramienta se apoya en cifras y fuentes oficiales verificables, no en opinión.
Preguntas frecuentes
¿Puedo registrar o reclamar derechos de autor sobre un texto o imagen generado 100% por IA?
No, al menos no en España. El artículo 5 del Texto Refundido de la Ley de Propiedad Intelectual reserva la condición de autor a las personas físicas. Un contenido generado íntegramente por una máquina, sin intervención creativa humana, no tiene un titular de derechos de autor que pueda ejercerlos: ni tú puedes impedir que un competidor lo copie, ni la IA ni el proveedor que la fabrica son autores en sentido legal.
Entonces, ¿si edito o combino el resultado de la IA con mi propio trabajo, sí es mío?
Puede serlo, si tu aportación es suficiente para reconocer una decisión creativa personal: reescribir sustancialmente, seleccionar y combinar varios resultados, añadir una estructura o un enfoque propios. No hay un porcentaje oficial que marque el umbral, así que conviene documentar el proceso (borradores, capturas, historial de cambios) por si algún día tienes que acreditar tu aportación.
¿Puede mi empresa tener problemas por usar una imagen generada por IA que se parece a una marca o un personaje existente?
Sí, y es uno de los riesgos que menos se tiene en cuenta. Los modelos de IA se entrenan con enormes cantidades de imágenes protegidas, y a veces el resultado reproduce elementos reconocibles de una marca, un logo o un estilo muy identificable. El caso Getty Images contra Stability AI en el Reino Unido, resuelto en 2025, es un buen ejemplo: el tribunal rechazó la infracción de derechos de autor, pero sí dio la razón a Getty en el uso no autorizado de sus marcas registradas, que aparecían de forma reconocible en algunas imágenes generadas.
¿Es legal que mi empresa entrene su propia IA con contenido de otras webs?
Depende. El Real Decreto-ley 24/2021 incorporó al ordenamiento español la excepción de minería de textos y datos, que permite este uso con carácter general, pero los titulares de las obras pueden oponerse expresamente mediante un mecanismo de lectura automática (el llamado opt-out, regulado en el artículo 67.3). Si vas a entrenar o afinar un modelo propio con contenido ajeno, hay que comprobar si esa reserva de derechos existe antes de asumir que la excepción te cubre.
¿Puedo usar IA para generar la voz o la imagen de un empleado o de un cliente en un anuncio?
No sin su consentimiento explícito. El artículo 7.6 de la Ley Orgánica 1/1982 considera intromisión ilegítima usar el nombre, la voz o la imagen de una persona con fines publicitarios o comerciales sin autorización, y esto aplica igual si esa voz o imagen se ha generado o clonado con IA. El Consejo de Ministros aprobó en julio de 2026 un proyecto de ley que refuerza precisamente esta protección frente a deepfakes y al uso comercial no autorizado de la voz.
¿Tengo que avisar de que un contenido de mi web o mis redes está generado por IA?
Depende de qué tipo de contenido sea. Desde el 2 de agosto de 2026 es exigible el artículo 50 del AI Act (Reglamento UE 2024/1689): el contenido sintético —imágenes, audio o vídeo generados o alterados con IA que puedan confundirse con contenido real— debe quedar identificado como tal, salvo que sea evidente por el contexto o se trate de una obra manifiestamente artística o satírica.
¿Qué es exactamente el opt-out de minería de datos y cómo sé si me afecta?
Es la forma en que un titular de derechos —un medio, un banco de imágenes, un autor— comunica de forma legible por máquina (normalmente mediante metadatos o un archivo tipo robots.txt) que no autoriza que su contenido se use para entrenar modelos de IA. Te afecta sobre todo si tu empresa desarrolla o afina modelos propios usando datos recopilados de internet, no tanto si solo usas herramientas de IA ya entrenadas por terceros como ChatGPT o Midjourney.
¿Qué debería documentar mi empresa para protegerse legalmente al usar IA generativa?
Como mínimo: qué herramienta se usó y cuándo, qué instrucciones (prompts) se dieron, qué edición o curación humana se aplicó después, y si el contenido final representa a personas reales o se parece a marcas existentes. Guardar esto no evita un conflicto, pero sí facilita defenderte —o corregir a tiempo— si alguien reclama derechos sobre algo que publicaste.